هاتف قديم في الدرج، ونماذج ذكاء اصطناعي تحتاج عادة إلى كمبيوتر قوي. هل يمكن جمع الاثنين والاستغناء عن تشغيل جهاز الكمبيوتر كلما احتجنا إلى تلخيص نص أو إعادة صياغة رسالة؟ هذا ما حاول الصحفي التقني Shekhar Vaidya اكتشافه عبر هاتف Samsung Galaxy S23 FE، في تجربة نشرها موقع XDA Developers في 24 أكتوبر 2026.
النتيجة لم تكن أن الهاتف تحول فجأة إلى بديل كامل عن ChatGPT أو Claude. الأهم أن التجربة كشفت كيف يمكن لإعداد بسيط في طريقة تشغيل التطبيقات أن يجعل النموذج المحلي يبدو غير قابل للاستخدام، ثم يعيد إليه أداءً مقبولًا.
طبيعة هذه المادة: تحليل عربي لتجربة منشورة أجراها الكاتب الأصلي. أرقام الأداء والتجارب أدناه تخص جهازه وإعداداته، ولم يُجرِ موقع devsamhan اختبارات مستقلة عليها.
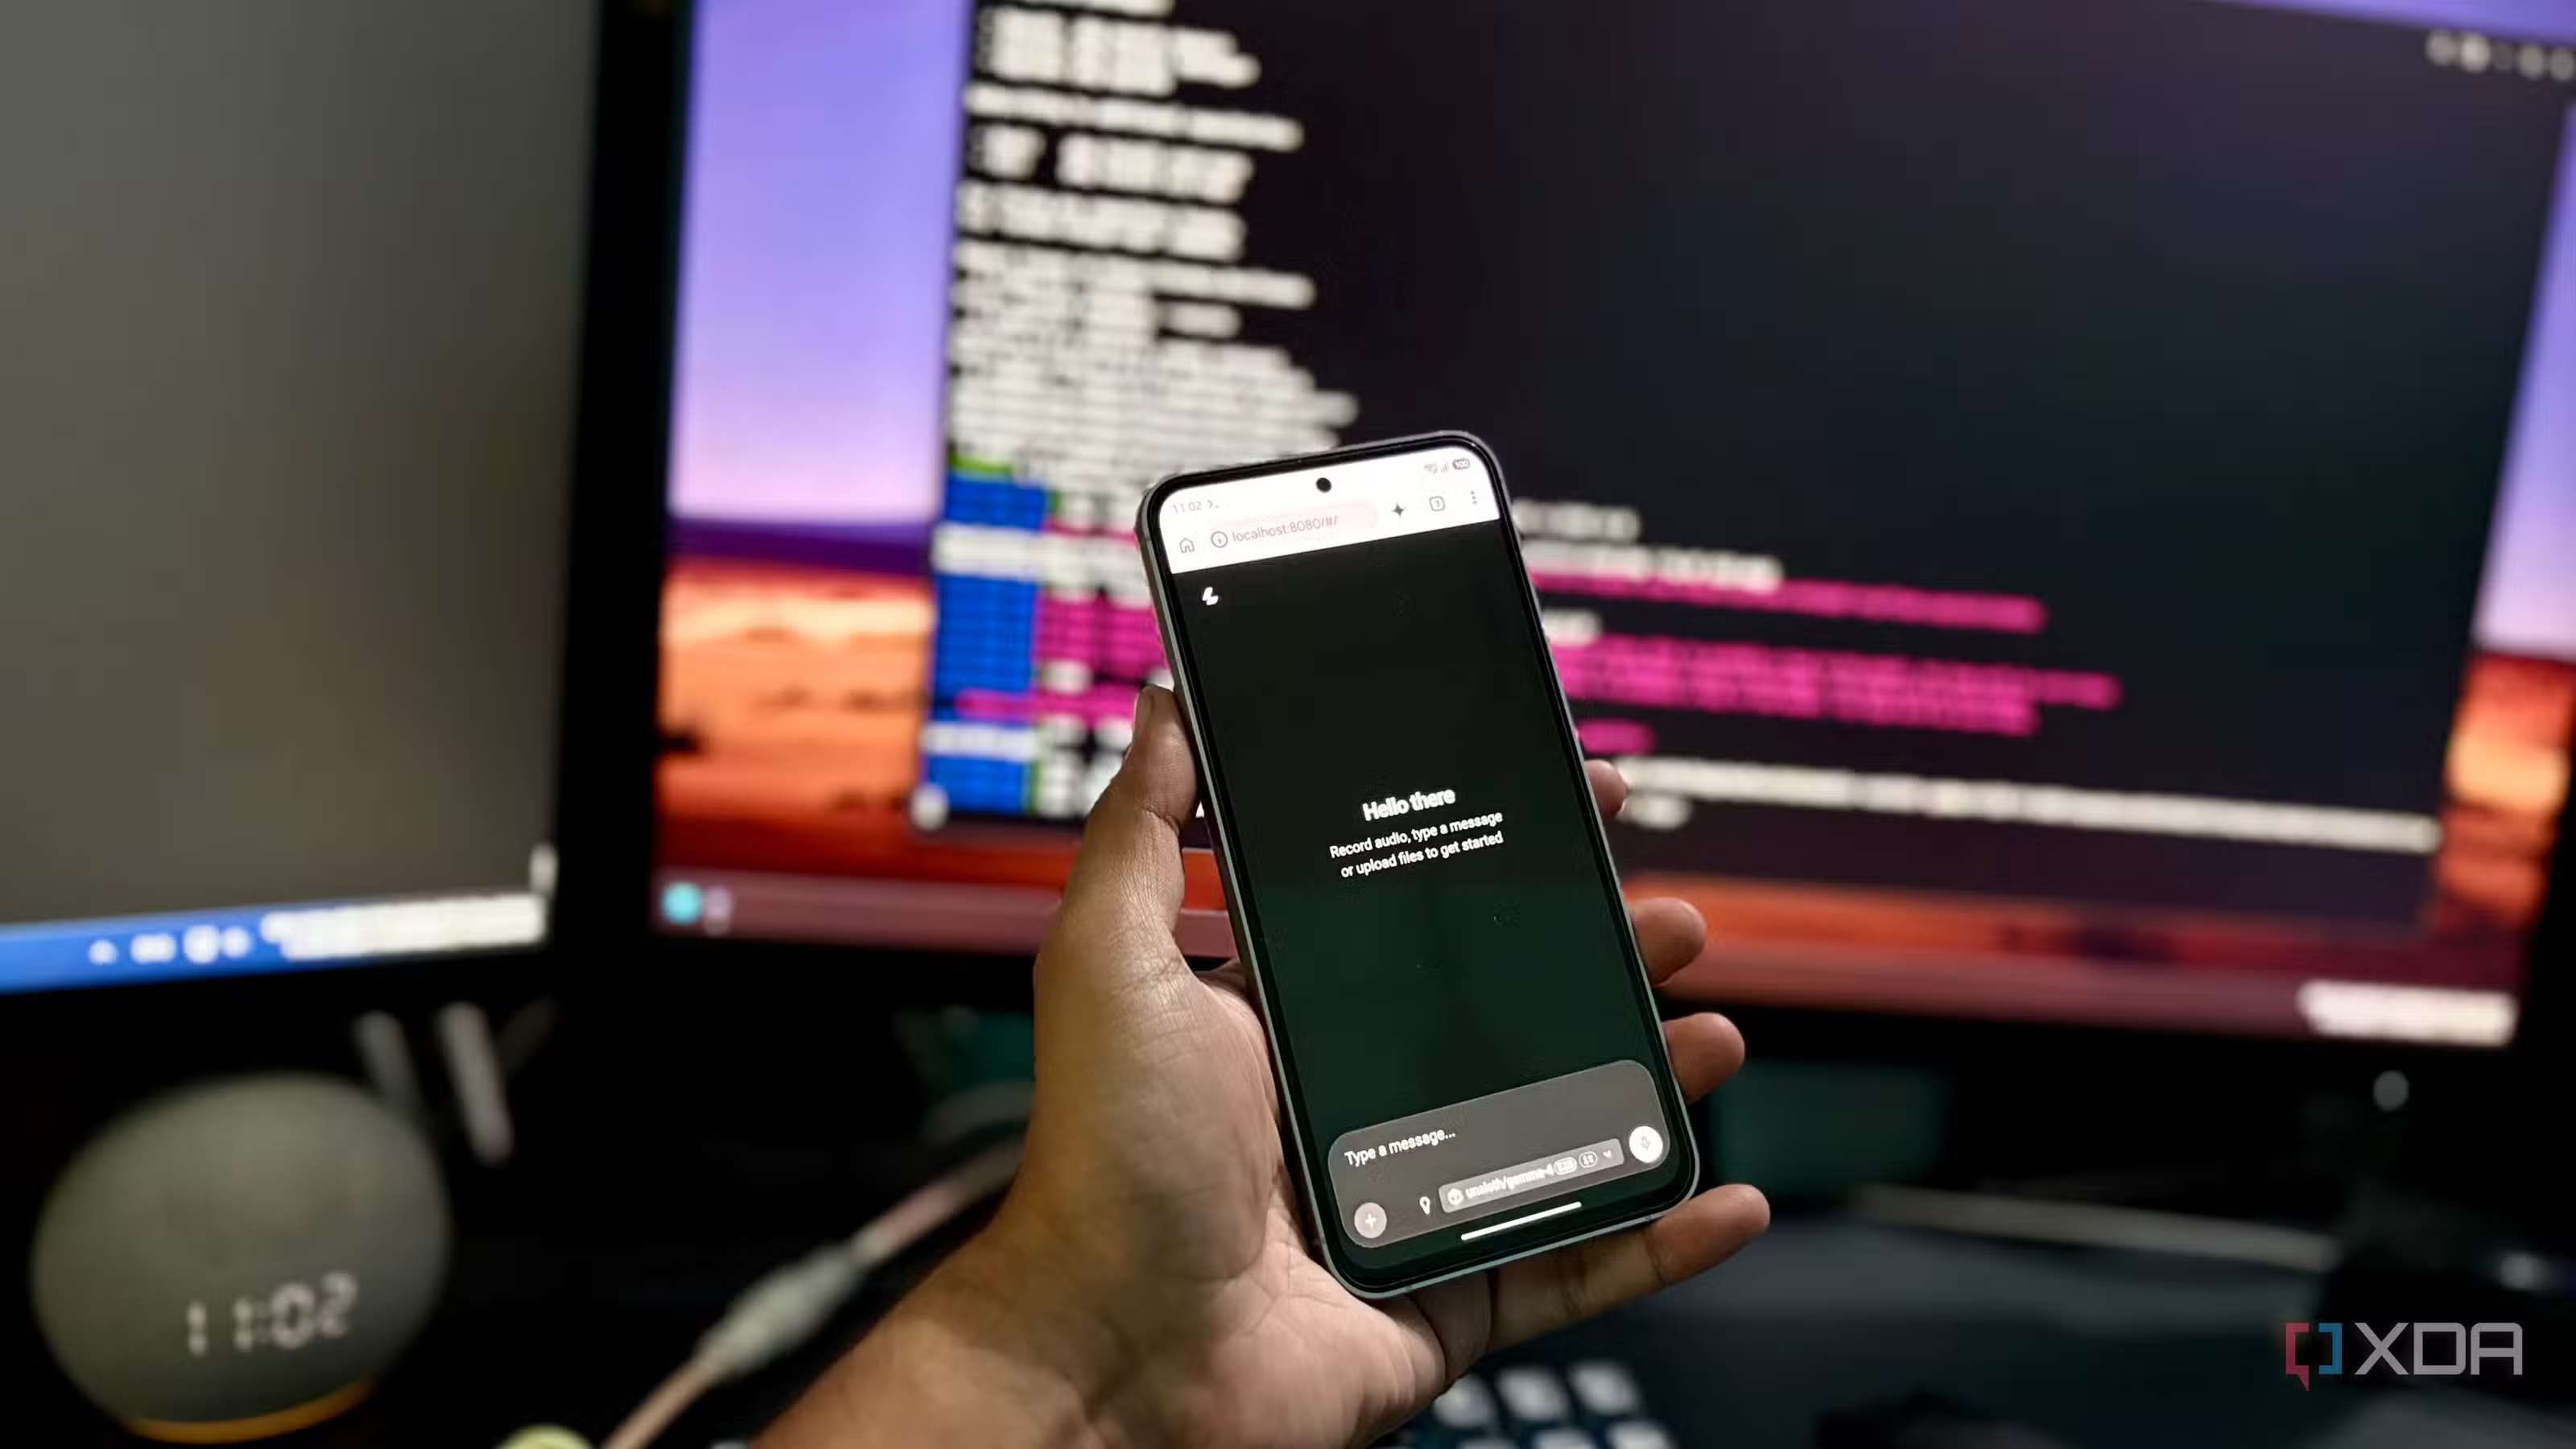
هاتف بإمكانات محدودة... لكنه ليس ضعيفًا
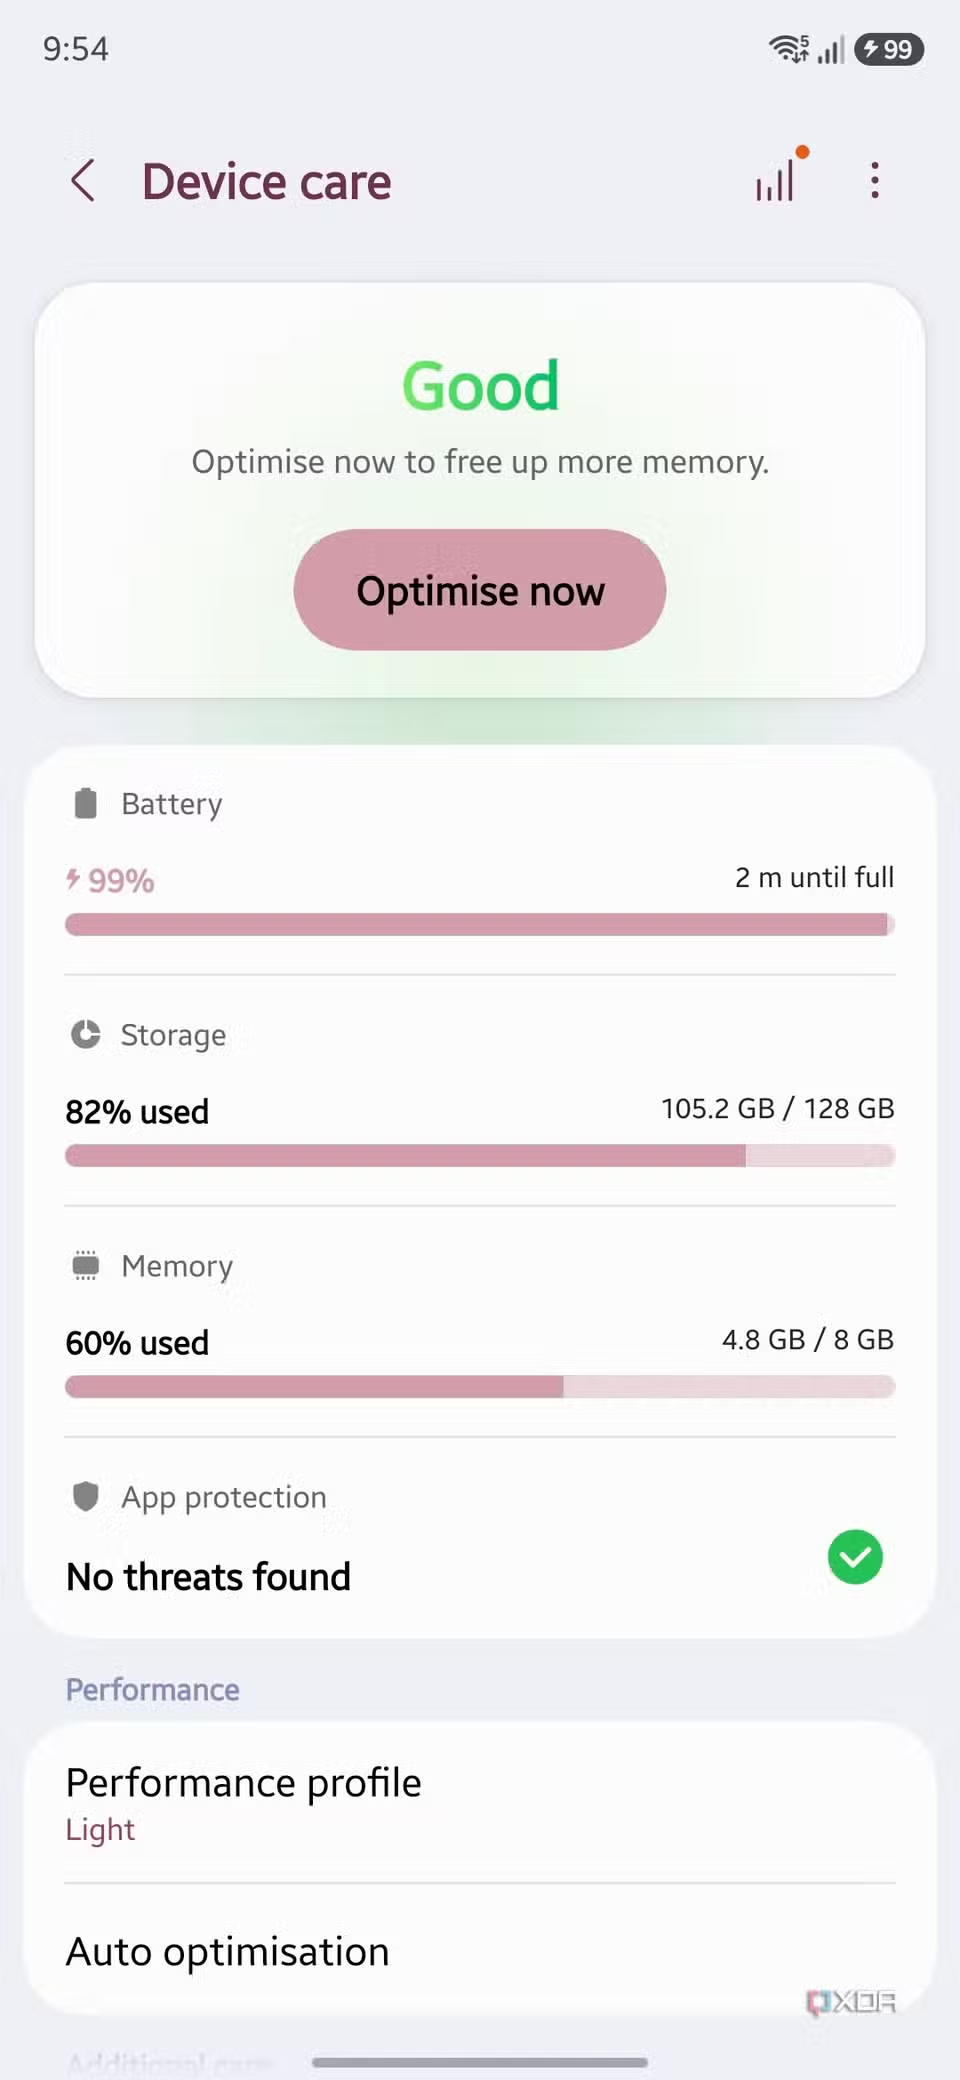
استخدم الكاتب نسخة Galaxy S23 FE المزودة بمعالج Exynos 2200 وذاكرة 8 جيجابايت RAM، أتاح نظام Android منها نحو 7.3 جيجابايت. وفي قراءة أولية كانت التطبيقات والنظام يستهلكان نحو 4.6 جيجابايت، ما جعل مساحة تشغيل النماذج الكبيرة محدودة منذ البداية.
كان أمامه مساران: تطبيق PocketPal الذي يوفر واجهة جاهزة لتحميل النماذج والدردشة معها، أو بيئة Termux لتشغيل خادم يستند إلى llama.cpp. اختار الأسهل أولًا.
المحاولة الأولى: التطبيق الأسهل لم يتحمل النموذج المطلوب
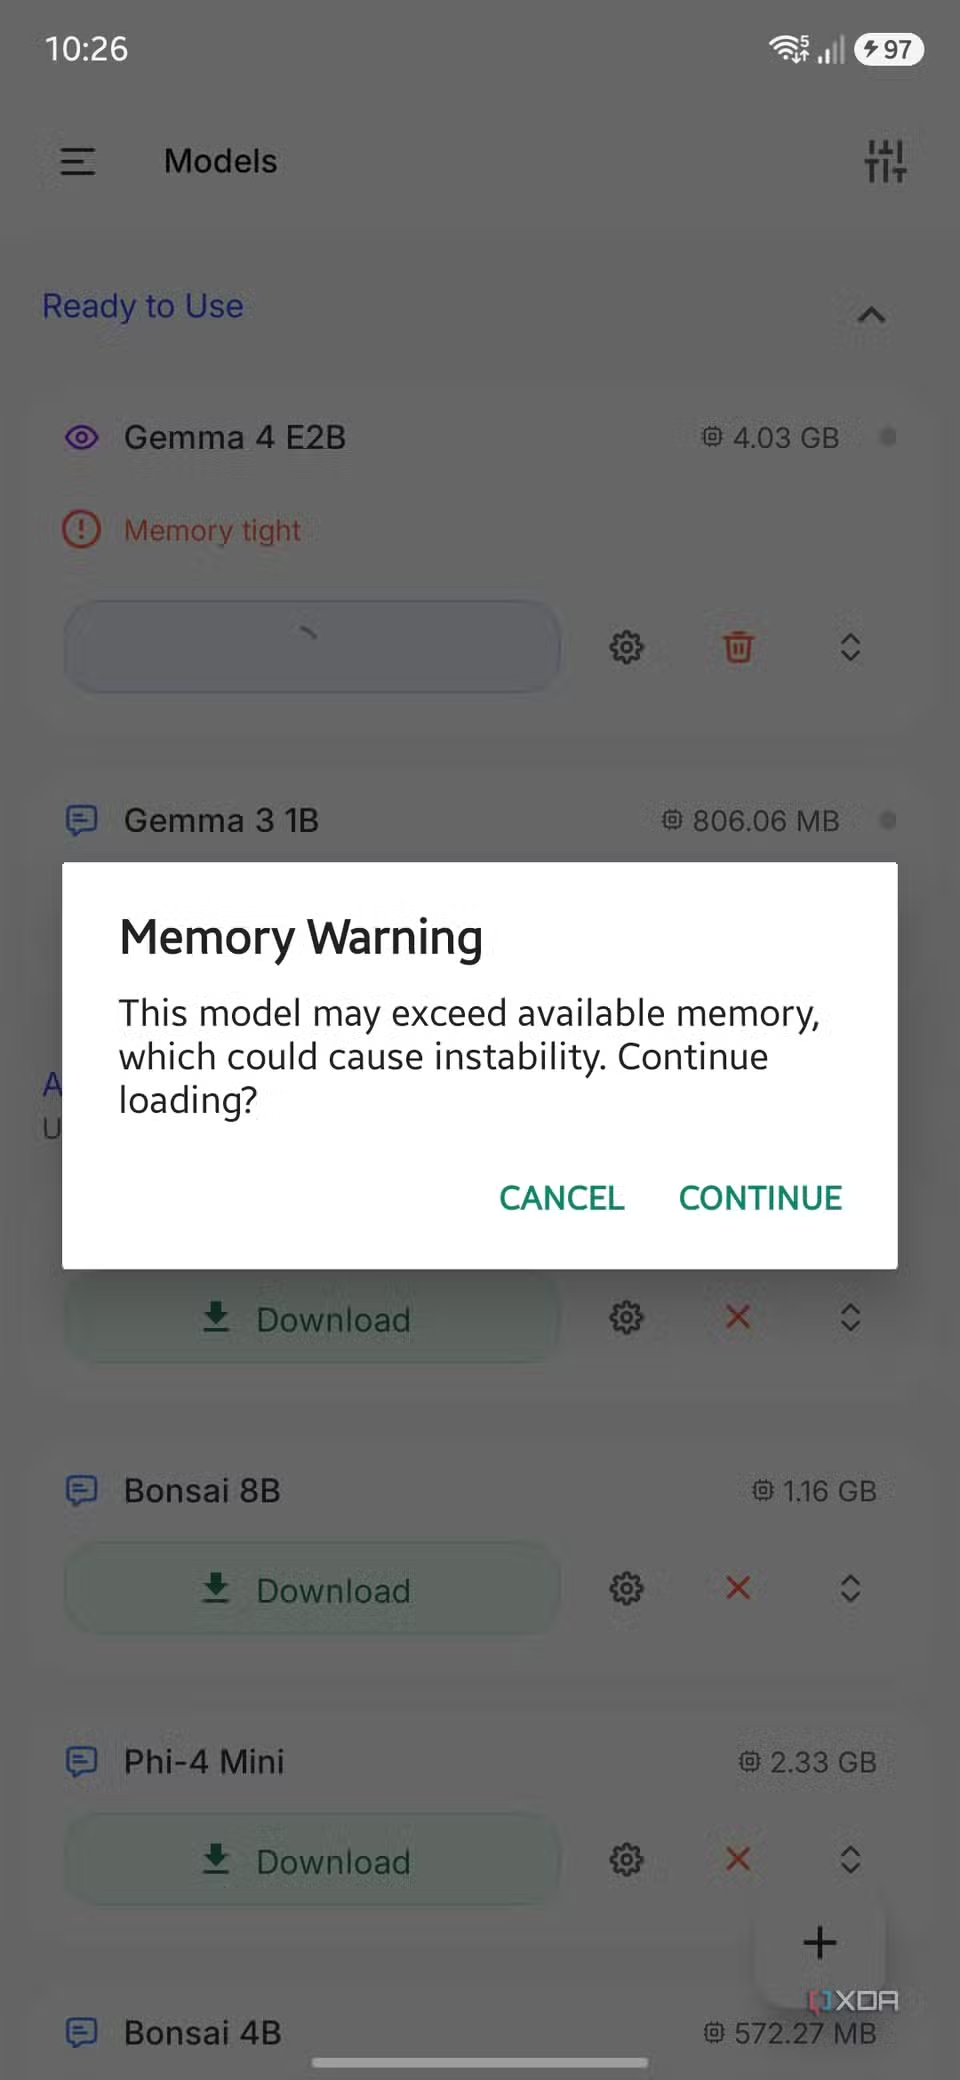
بدأ الكاتب بنموذج أصغر هو Gemma 3 1B للتأكد من أن الهاتف يستطيع تشغيل نموذج محلي أصلًا. ونجح التشغيل. لكنه كان يريد تجربة Gemma 4 E2B، فحاول تحميله داخل PocketPal. ظهر تحذير بشأن الذاكرة، ثم أغلق التطبيق نفسه أثناء التحميل، وتكرر ذلك أكثر من مرة.
هذه نقطة مهمة لكل من يخطط لاستخدام هاتف قديم في الذكاء الاصطناعي: نجاح تشغيل نموذج صغير لا يعني أن كل نموذج مضغوط سيعمل عليه. حجم ملف النموذج ليس كل ما تحتاجه الذاكرة؛ فهناك ذاكرة للنظام، وسياق المحادثة، وأعباء التشغيل الأخرى.
Termux نجح في التحميل... ثم خيّب التوقعات
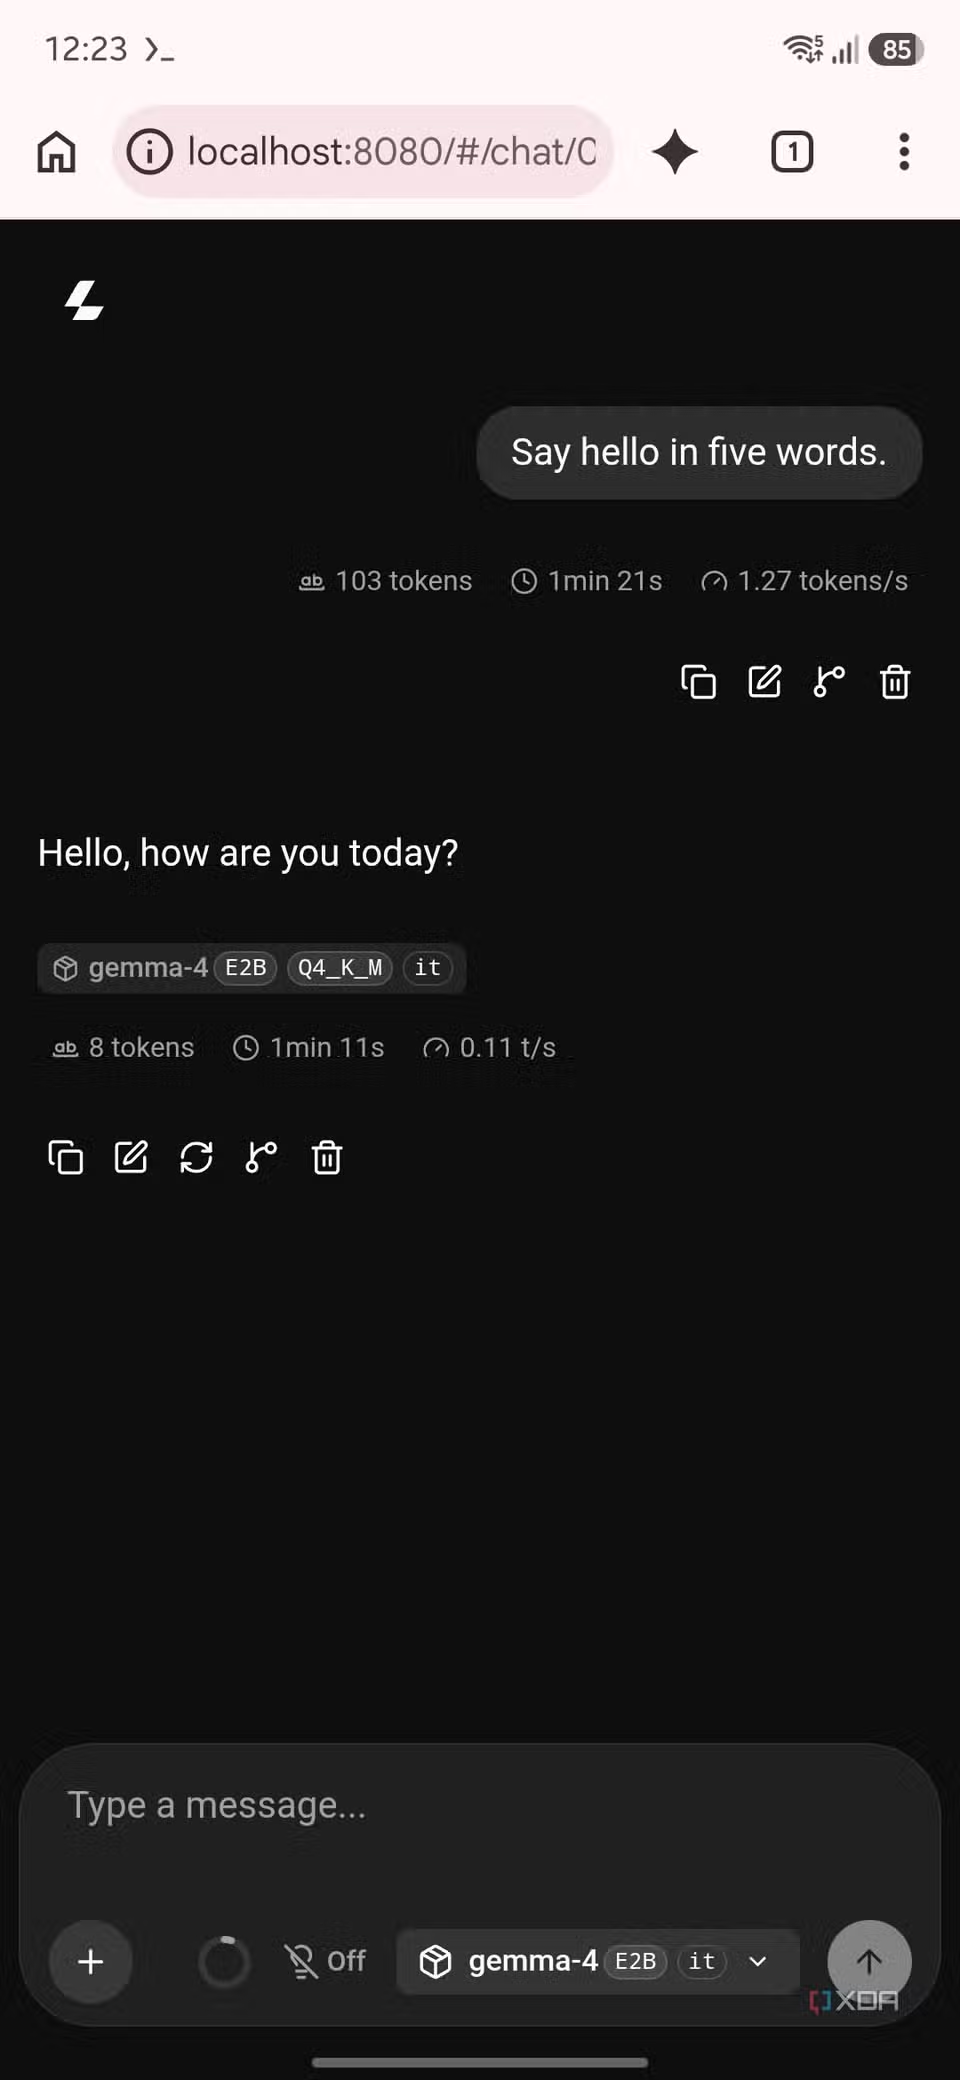
انتقل الكاتب إلى Termux وشغّل حزمة llama.cpp، ثم حمّل إصدارًا مضغوطًا من Gemma 4 E2B بتكميم Q4_K_M، وفتح واجهة الخادم المحلية على localhost:8080.
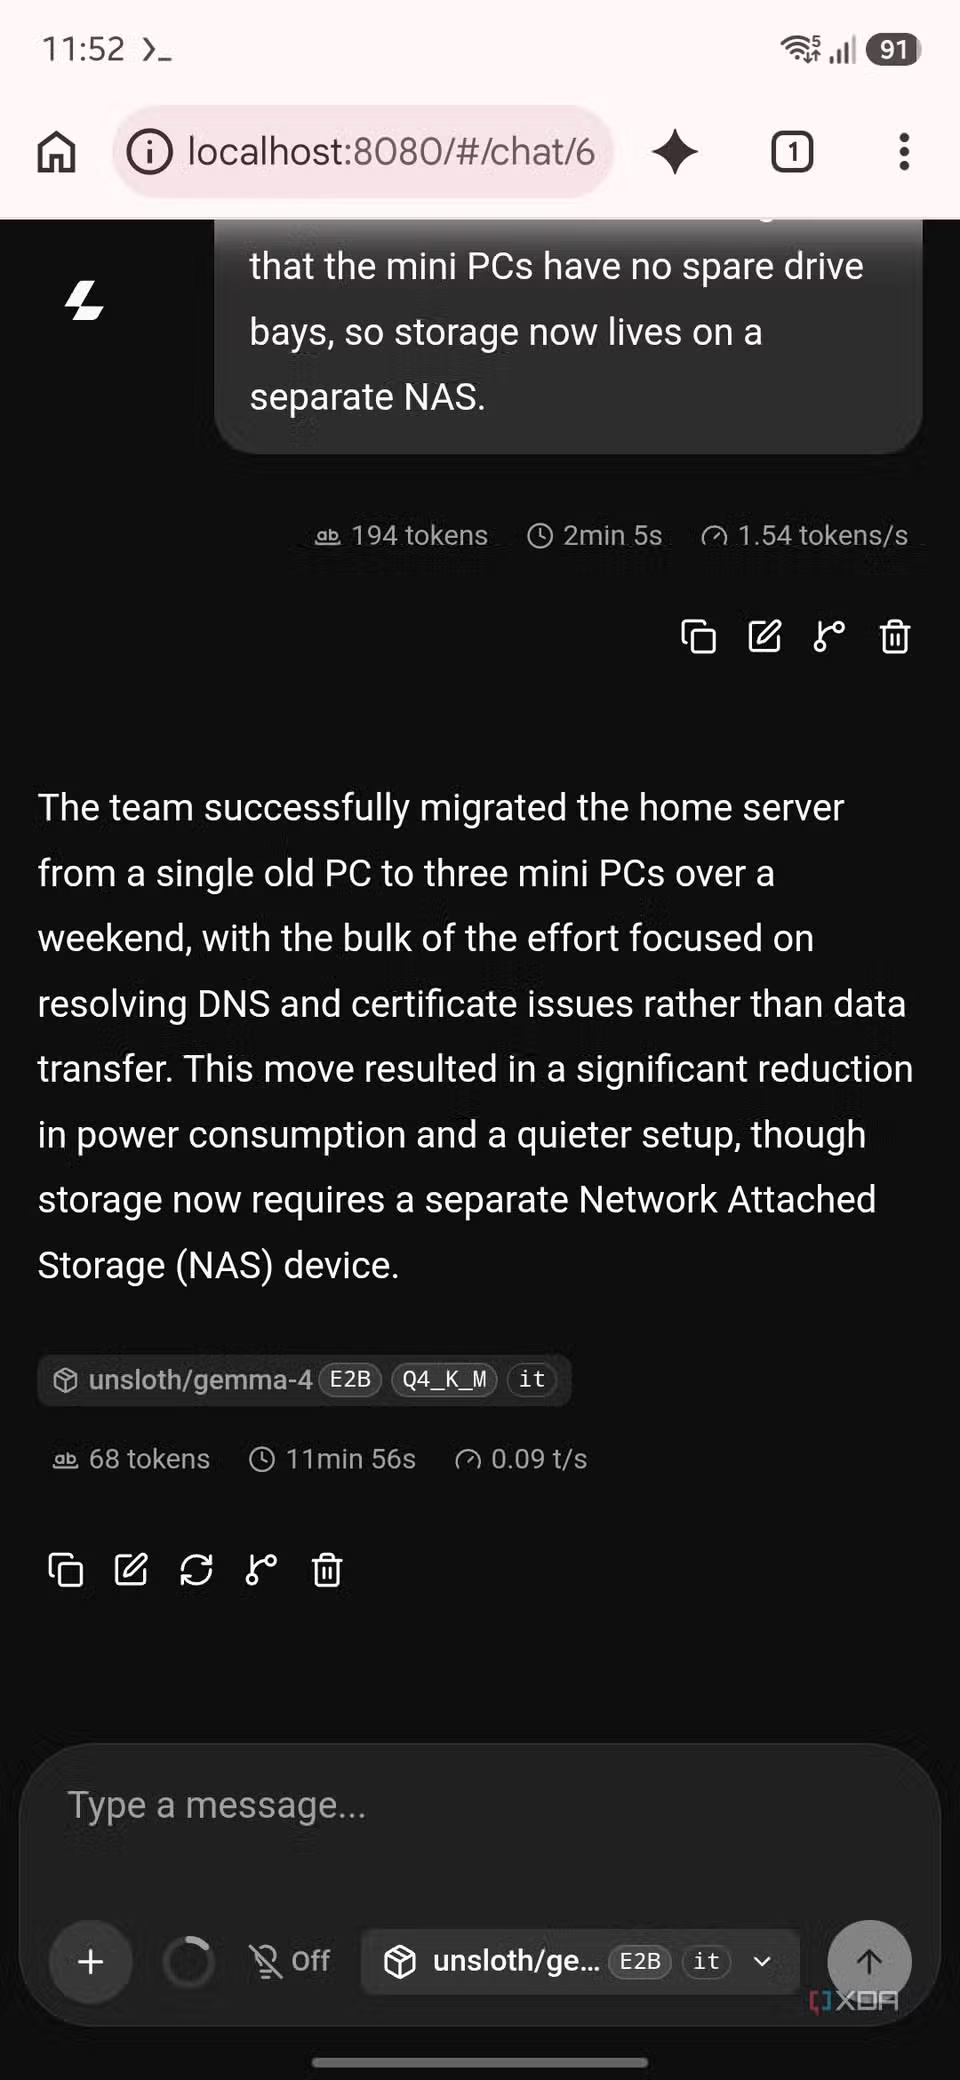
هذه المرة عمل النموذج دون انهيار واضح في الذاكرة، لكن الأداء كان شبه متوقف: في سؤال قصير لم تتجاوز سرعة توليد الإجابة 0.11 رمزًا في الثانية تقريبًا، واستغرق توليد ثمانية رموز نحو 71 ثانية. وفي اختبار تلخيص آخر انخفضت سرعة التوليد إلى 0.09 رمز/ثانية، واستغرقت إجابة من 68 رمزًا قرابة 12 دقيقة.
من الصعب وصف ذلك بأنه مساعد عملي، حتى لو كان يعمل محليًا بالكامل.
المفاجأة: المشكلة لم تكن في النموذج وحده
راجع الكاتب خيارات توفير الطاقة، وتأكد من أن Termux مسموح له بالعمل دون قيود البطارية المعتادة. ثم جرب نموذج Qwen 3.5 2B في البيئة نفسها، فواجه بطئًا مشابهًا. لكن تشغيل Qwen عبر PocketPal أعطى نتيجة مختلفة تمامًا: نحو 11.14 رمز/ثانية في اختبار التوليد المدمج، ونحو 9 رموز/ثانية في استخدامات فعلية، وفق ما نشره.
هنا ظهر سؤال جديد: هل المشكلة في الهاتف أم في طريقة تعامل Android مع Termux عندما تعمل واجهته في الخلفية؟
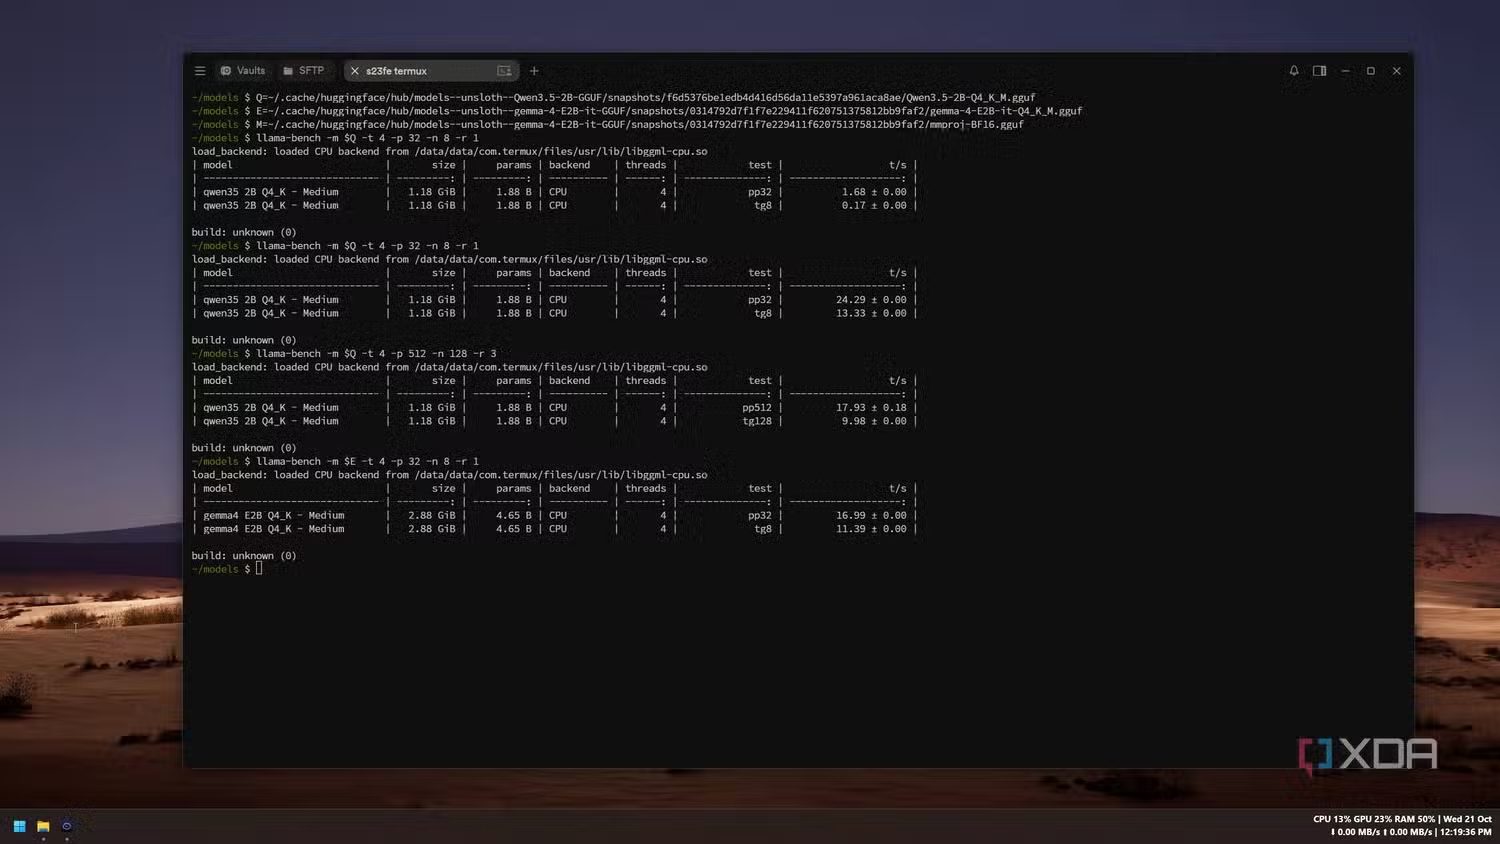
اختبر الكاتب النموذجين عبر أداة llama-bench وقارن تشغيل Termux في المقدمة وتشغيله بينما المتصفح ظاهر على الشاشة. أظهر اختبار Qwen القصير 0.17 رمز/ثانية تقريبًا في الخلفية، مقابل 13.33 رمز/ثانية عندما أصبح Termux في المقدمة. وسجّل Gemma 4 E2B نحو 11.39 رمز/ثانية في اختبار قصير مع Termux في المقدمة.
هذه نتائج قياس موضعية؛ لا يصح تعميمها على جميع هواتف Samsung أو جميع نسخ Android.
لماذا أثّر وضع الشاشة في سرعة الذكاء الاصطناعي؟
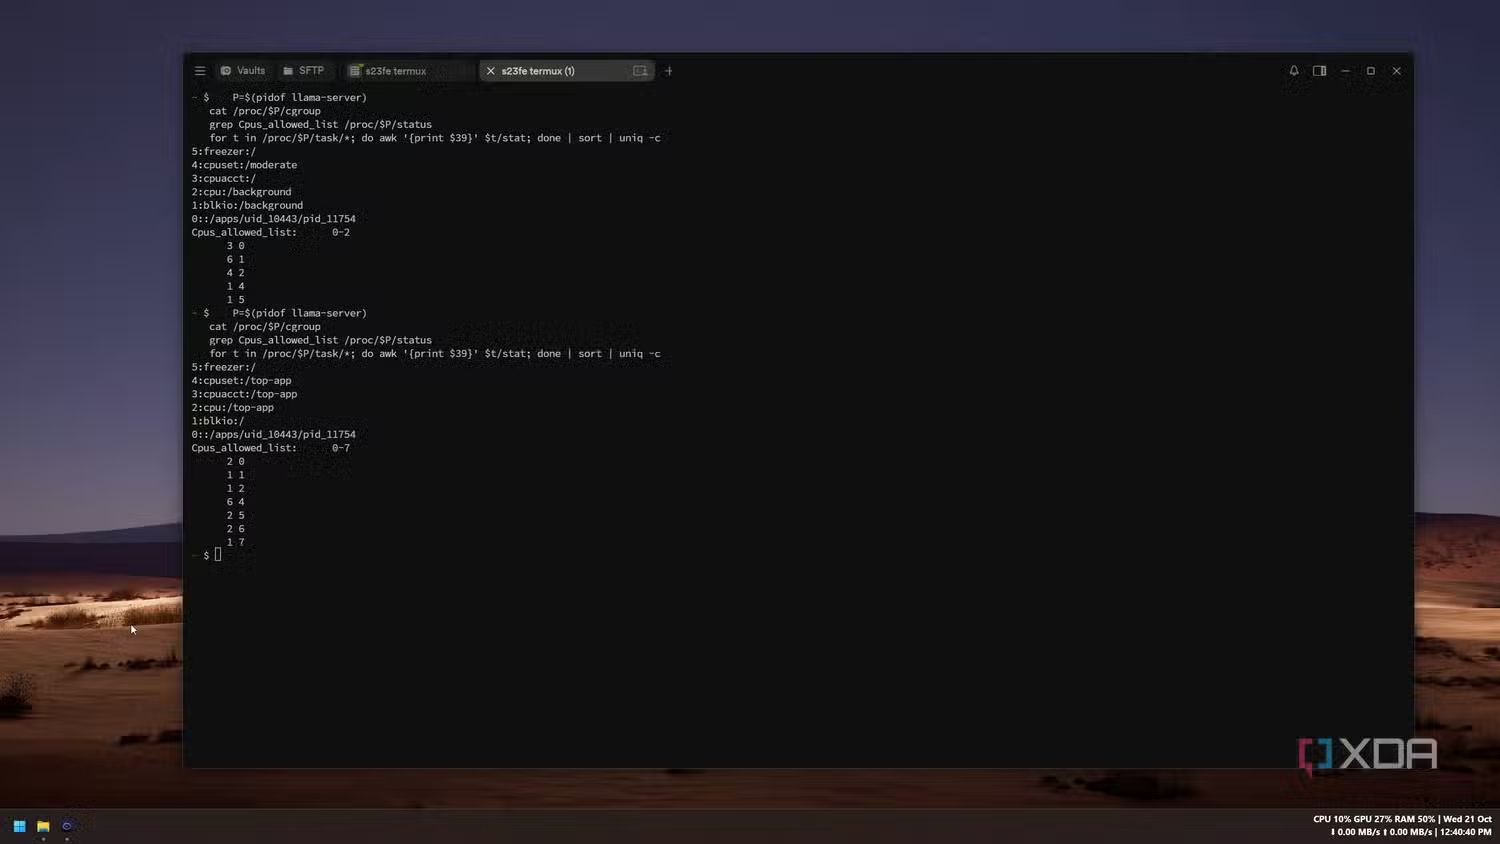
عند فحص الأنوية المسموح للتطبيق باستخدامها، وجد الكاتب أن Termux كان يستطيع الوصول إلى الأنوية 0–7 في المقدمة، بينما انخفض النطاق المسموح إلى 0–2 عندما انتقل إلى الخلفية. وهذا يدعم فرضية أن جدولة المهام في النظام كانت تقيد عمل الخادم، لكنه لا يثبت وحده أن السبب سلوك عام في Android أو خاص بنسخة Samsung المستخدمة.
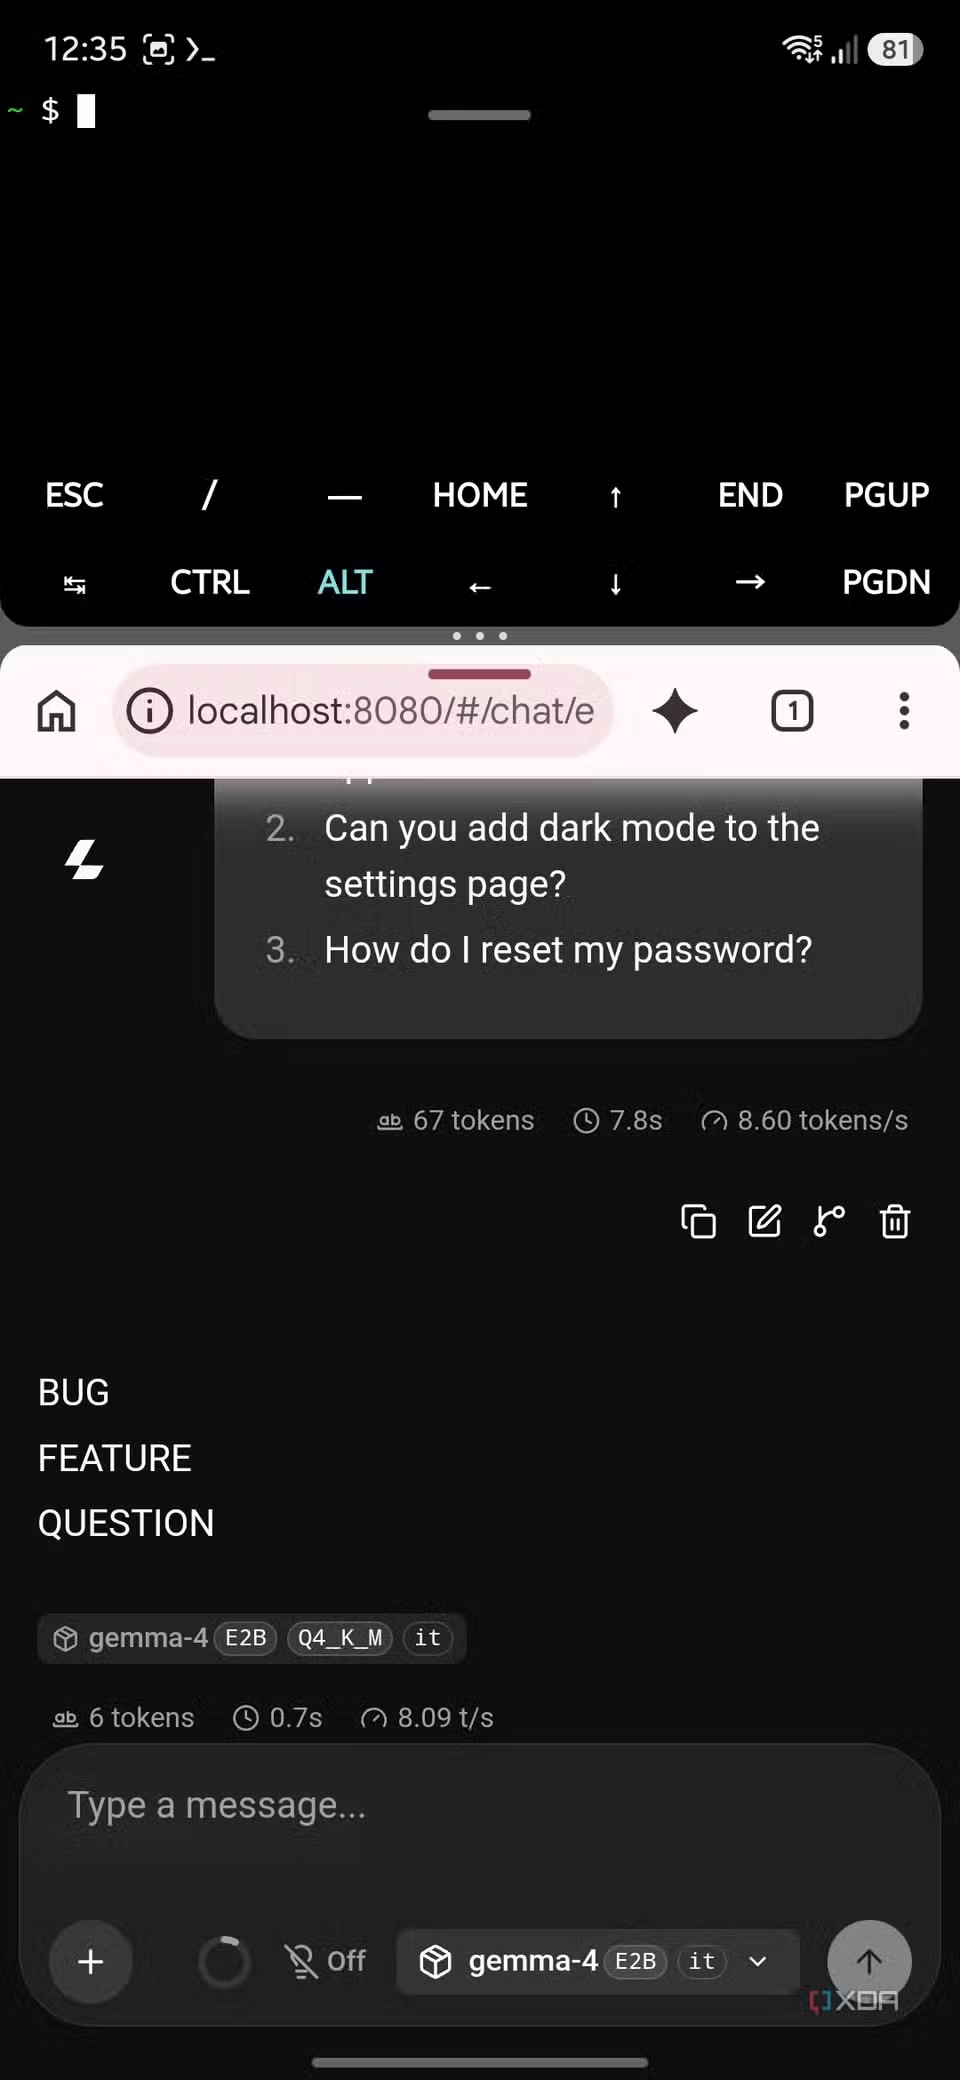
كان الحل العملي غير متوقع: تقسيم الشاشة بين Termux والمتصفح حتى تبقى نافذة Termux مرئية ولا يُعامل تشغيلها كخلفية عادية.
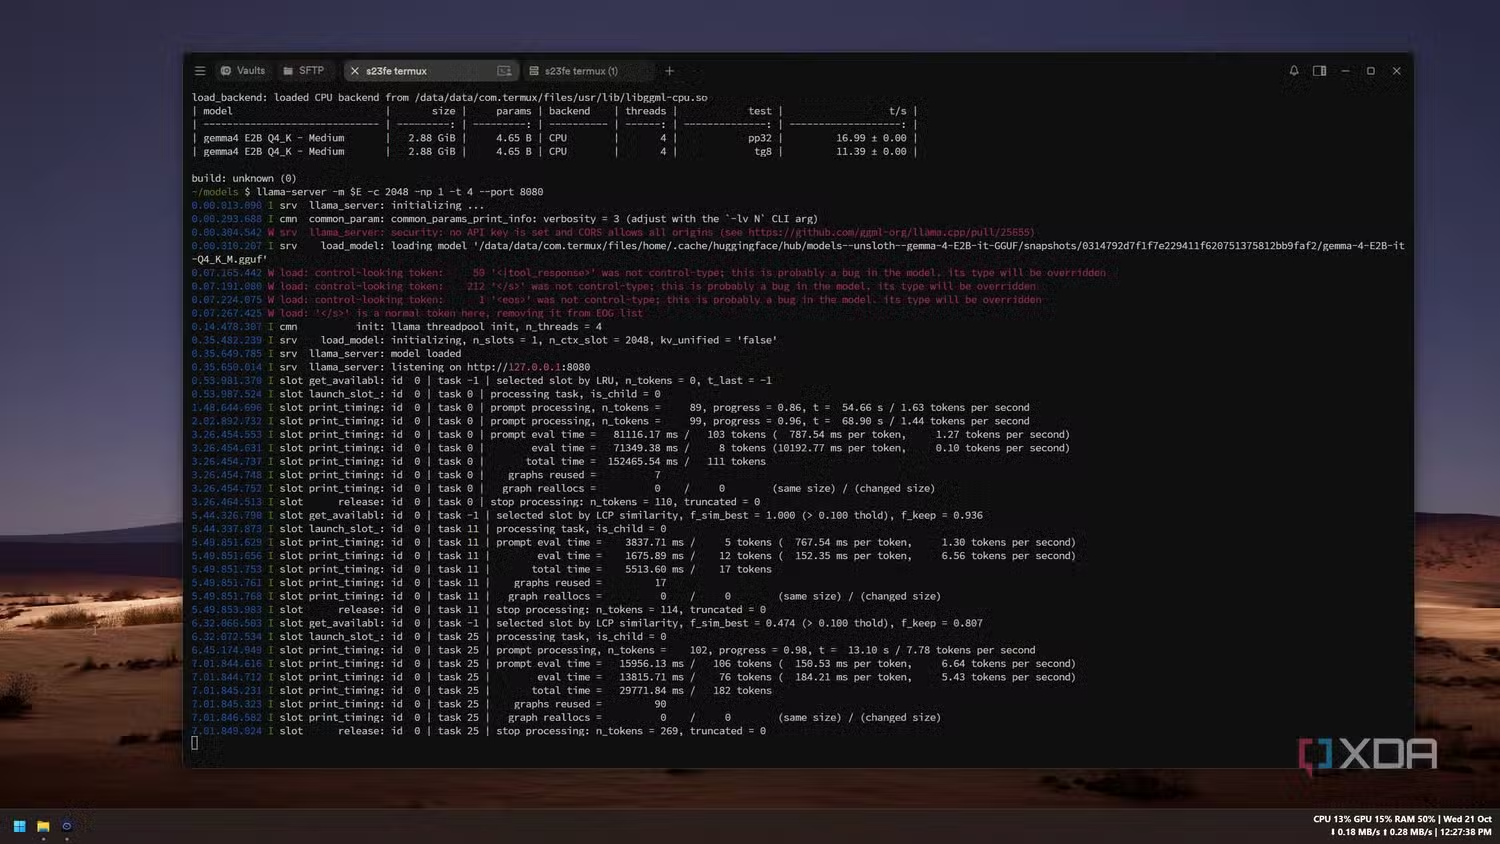
مع تقسيم الشاشة، أصبح Gemma 4 E2B يحقق في الاستخدام الفعلي نحو 5.4 إلى 6.6 رموز/ثانية. وفي اختبار أطول أنتج 730 رمزًا خلال دقيقتين وأربع ثوانٍ. ليس أداءً سريعًا مقارنة بخدمات السحابة، لكنه يغيّر التجربة من انتظار طويل جدًا إلى إمكانية تنفيذ مهام قصيرة.
الأداء ليس كل شيء: هل يمكن الوثوق بالإجابات؟
جرّب الكاتب مهامًا قريبة من استخدامه اليومي، مثل تلخيص النصوص، وإعادة صياغة الرسائل، والتصنيف. وجد أن Gemma 4 E2B قدّم في اختباراته نتائج أنسب من Qwen 3.5 2B في بعض هذه المهام، بينما اخترع Qwen أسماء إصدارات ومعلومات غير صحيحة بثقة. هذه ملاحظة من مجموعة أسئلة محدودة لا تعني أن نموذجًا يتفوق مطلقًا على الآخر.
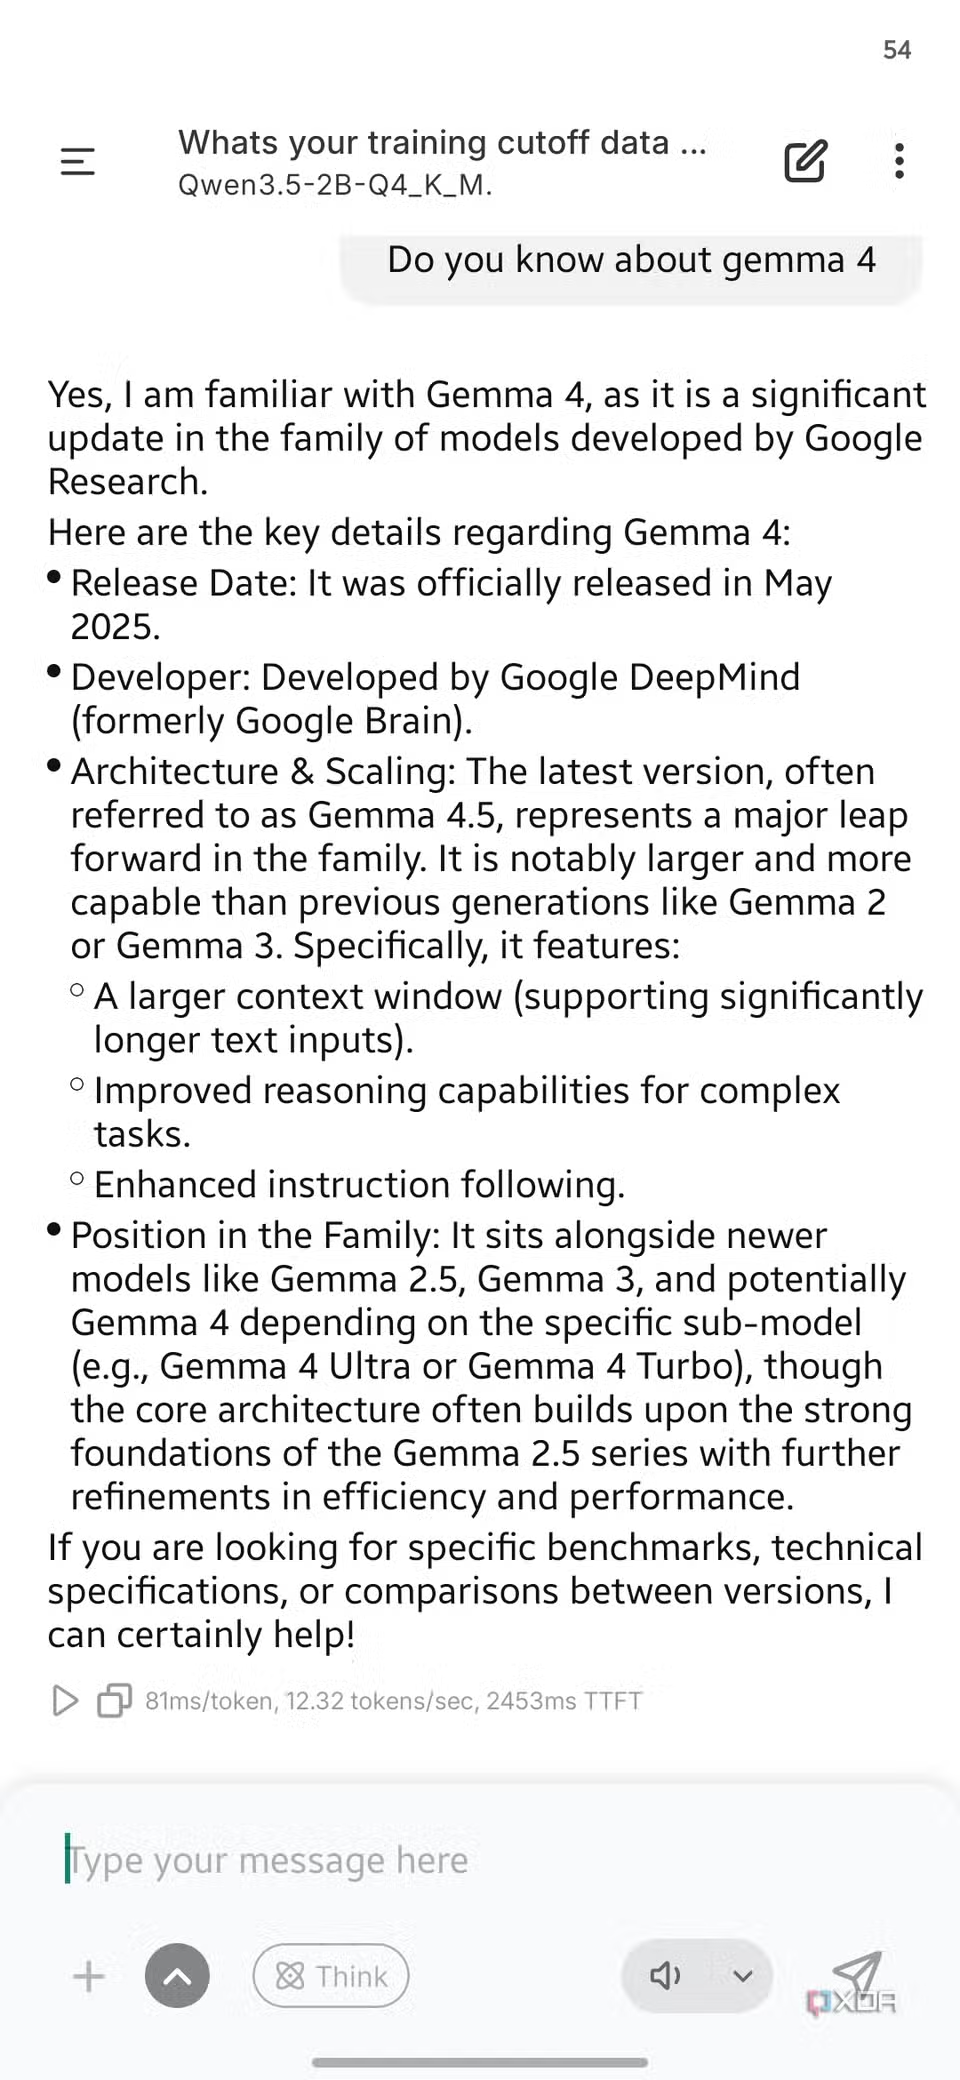
تظل النماذج الصغيرة معرضة للهلوسة، وقد تسيء تفسير التعليمات أو تخطئ في التواريخ والحسابات. لذلك لا ينبغي الاعتماد عليها وحدها في معلومات طبية أو قانونية أو مالية أو في نتائج تحتاج إلى تدقيق مرتفع.
هل يستحق تحويل هاتف قديم إلى خادم محلي؟
إذا كنت تملك هاتفًا قديمًا بذاكرة مناسبة، وترغب في تجربة تلخيصات قصيرة أو كتابة مسودات دون إرسال المحتوى إلى خدمة سحابية، فالفكرة تستحق الاستكشاف. لكن لا تتعامل معها كحل جاهز للعمل طوال اليوم؛ إذ تحتاج إلى اختبار استقرار الجهاز والحرارة واستهلاك البطارية، وتأمين أي وصول عبر الشبكة، وعدم فتح الخادم المحلي للإنترنت دون حماية مناسبة.
ولا تنسَ أن العمل المحلي لا يعني الخصوصية المطلقة: يعتمد ذلك على التطبيق المستخدم، ومصدر النموذج، وطريقة إعداد الشبكة، وأي خدمات خارجية يتصل بها التطبيق.
الخلاصة: كشف الهاتف القديم عن إمكانية حقيقية، لكن الدرس الأهم لم يكن اسم النموذج أو عدد المعلمات. لقد كان في فهم كيفية تعامل النظام مع التطبيق. أحيانًا يكون فارق الأداء الهائل نتيجة وضع تشغيل غير ملائم، لا عجزًا كاملًا في العتاد.
التجربة الأصلية: Shekhar Vaidya، XDA Developers، 24 أكتوبر 2026: قراءة المقالة الأصلية.